图像生成基础
给模型看一只杯子,让它说出“红色”,我们已经试过了。现在把方向反过来:只给一句“一只红色陶瓷杯”,让模型交出图片。
这件事为什么更难?一句话没有规定杯口的弧度、灯光的位置、杯柄朝哪边。满足描述的图片可以有很多张。模型需要学会的,便不只是找到一个唯一答案,而是从许多合理的答案中生成一个。
这一章先用 8×8 的手写数字把计算拆开,再走到真正的文字生成图片。我们会亲手训练自编码器、一个小型扩散模型和一个流匹配模型,最后使用预训练的 SD-Turbo 做六次固定对照。生成成功的例子值得看,杯子被截断、把手变多、数量不对的例子同样值得看。
如果你还记得均方误差、标准正态分布和“输入经过网络得到输出”,就可以开始。涉及连续时间时,我们先用“每次走一小步”来理解,不需要先学会求解微分方程。
1. 先把图片装进一个小盒子
一张 8×8 灰度图可以看作 64 个数。每个数表示一个像素有多亮;按固定顺序展开,就得到向量 。
现在做一个看似有点绕的任务:让网络先把这 64 个数变成 8 个数,再从这 8 个数尽量还原原图。
是编码器, 是解码器, 是各自的参数。中间的 叫潜变量或潜表示:它不直接对应屏幕上的像素,却保存了重建所需的信息。
这个组合叫自编码器。训练时,输入和目标都是同一张图片,网络需要穿过中间的窄通道,再把图片还回来。把像素缩放到 后,我们可以使用:
是图片数, 是每张图的像素数,这里为 64。误差在所有图片、所有像素上取平均,所以不同图片批次之间有一致的尺度。
下面是真实训练得到的结果。前两行分别是输入与重建,第三行稍后解释。
图 1:每类取测试划分中按原顺序出现的第一张图;这里只展示 0~4,记录中保存了 0~9。第三行的潜变量独立随机采样,与上方图片没有一一重建关系。
数字的大致轮廓留下来了,但笔画变软,有些细节消失。这个结果并不神奇:中间只留 8 个数,网络必须决定哪些变化值得保留。这里减少的是表示的维度,并不能直接宣称文件缩小了八倍;存储格式、数值精度和模型本身也要占空间。
能重建,不等于会从随机数生成
训练好的解码器能接收 8 个数,那么,随便生成 8 个标准正态随机数交给它,是不是就能画一个新数字?
图 1 的第三行就是这个尝试。许多输出像灰色斑块,和上面的数字相去甚远。原因在于,普通自编码器只练习过“解码编码器实际给出的潜变量”。它没有保证编码器的输出按标准正态分布排列;随机抽到的位置,可能根本不在它熟悉的区域。
这也是变分自编码器(VAE)要处理的问题之一。它让编码器给出一个分布,例如每个潜变量的均值 和标准差 ,再通过:
得到潜变量。 表示逐元素相乘。训练既关心重建,也用 KL 散度约束编码分布与选定先验的差异,给“从先验抽样,再解码”建立依据。约束过强会妨碍重建,过弱又可能让抽样区域衔接不好。
本章实现的是普通自编码器,没有把图 1 的模型称为 VAE。VAE 的概率推导可以从 Kingma 与 Welling 的 Auto-Encoding Variational Bayes继续读;这里先记住:压缩表示和为生成安排潜空间,是相连但不同的两件事。
2. 一张数字图片,怎样变成噪声
生成图片还有另一条路。我们先学会把清晰图片逐渐弄乱,再训练一个网络判断怎样往清晰的方向走。
把原图记作 。下面用的像素范围改为 :黑色接近 ,白色接近 1。每一步加入独立的标准正态噪声:
是第几步, 决定这一小步加入多少噪声。原信号略微缩小,噪声略微加入;重复足够多次,笔画就被淹没了。
为什么系数带平方根?独立噪声的方差按系数的平方变化。这样安排,信号和新噪声的方差权重分别是 与 ,而两者相加为 1。
训练时不必每次从第一步一路加到第 步。把各步保留信号的比例乘起来:
就能直接得到第 步的条件分布采样:
这里 是一次新抽取的标准正态噪声,代表累积噪声。 越小,原图的贡献越少。本例用 64 步的余弦噪声日程,末端约为 ,已经很接近纯噪声的状态。
图 2:第一行用同一份噪声代入不同 的直接采样公式,方便观察信号逐渐消失,并非连续执行的马尔可夫加噪轨迹。后两行是两种模型的实际生成中间状态;它们从新的噪声出发、指定生成 0,不是在恢复第一行的数字 3。显示时把数值映射到灰度并截到可显示范围。
3. 扩散模型在学习什么
加噪时,我们知道原图,也知道自己加入了哪些随机数。于是可以出一道训练题:
这是带噪的图片,现在处在第几步也告诉你。请估计其中的噪声。
把这个网络记作 。其中 是条件,本章的小实验用数字类别,例如“画 3”。网络的输出仍然有 64 个数,分别预测每个像素位置的噪声。
训练目标很直接:
表示对随机选择的图片、时间和噪声取平均。实现中,每批重新抽样,用批次均方误差近似它。时间不能省略:同样一片灰色,在轻度污染和几乎纯噪声时,应该如何解释,很不一样。
注意,网络没有拿到当前样本的原图。如果不同原图和噪声可能组成相近的 ,它不可能总把那一次噪声精确猜出来。它学到的是给定当前信息时有用的估计,并通过许多生成步骤逐渐形成图片。
推理时,从一张新的噪声开始
训练完毕后,我们不再提供原图。先抽取 ,指定类别,再反复调用网络:
- 估计当前噪声。
- 用估计结果计算下一步的中心位置。
- 除最后一步外,再加入该步骤所需的随机扰动。
这是一种 DDPM 采样方式。模型每次处理整幅小图;这里并不是像语言模型那样,先固定左上角像素,再依次生成后面的像素。
选读:代码里的反向一步究竟怎么算?
先从加噪公式解出对原图的估计:
本例把这个估计截到 ,再计算:
是新抽取的标准正态噪声,。因此 时 ,最后一步不再添加随机扰动。
这些系数来自已知原图时高斯加噪过程的后验分布;生成时把未知原图替换为网络的估计。这里只使用固定后验方差,没有训练网络去预测方差。对 的截断也是具体实现选择,不应悄悄从复现条件里省掉。
DDPM 原论文给出了这一训练与采样思路;Improved DDPM讨论了噪声日程等改进。本章只取便于拆解的小型配置,不复现论文的大图像实验,也不借用其质量指标作为自己的结果。
4. 条件怎样进入画面
在小实验里,类别编号先经过嵌入层变成 16 个数,再和当前图片、时间特征拼在一起送入网络。网络既要看“现在画成什么样”,也要知道“我们想画什么”。
文字条件则通常需要文本编码器。文本产生一串表示,图像网络通过交叉注意力等方式读取它们。上一章是图像表示帮助语言模型回答;现在是文字表示帮助生成网络决定图片该往哪里变。
条件也可以是一张参考图、轮廓、深度或空间布局。但条件能够输入,不等于每一条约束都能严格满足。“红色”“三个”“每个都写 TEA”会给模型带来不同的困难。
“更听话”的引导,为什么不是越大越好
一种常见办法叫无分类器引导(classifier-free guidance,CFG)。训练时,部分样本不提供条件,让模型同时学会有条件和无条件的估计。推理时组合两者:
表示空条件, 是这里定义的引导强度。 时得到有条件估计; 时沿两种估计的差异再走远一些。它可能加强条件影响,也可能损失多样性或产生过强的色彩、纹理;不是把旋钮拧大就必然更好。
具体机制与权衡见 Classifier-Free Diffusion Guidance。本章的小数字模型始终接收类别,没有训练无条件分支,因此代码不执行 CFG。后面的 SD-Turbo 又有自己的蒸馏训练与调用约定,也不能机械套用上式中 的含义。
5. 流匹配:另一种从噪声走到图片的方法
刚才的网络学习预测噪声。现在换一道题:如果把噪声和图片之间铺上一条路,让网络学习此时此地应该朝哪个方向走、多快走,会怎样?
先独立抽取一份噪声 和一张真实图片 ,连接两端:
这一节改用连续时间: 是噪声, 是图片。它与前面“步数越大、噪声越多”的编号方向相反,阅读代码时要先看约定。
沿这条直线走,速度是恒定的:
用一个数试试:起点是 ,终点是 3,总时间为 1,那么速度就是 4。走到 时,位置为 0;再走相同的一小段时间,位置为 1。
训练网络 去预测速度:
这就是本章使用的简单条件流匹配目标。它用随机配对的噪声与数据构造路径,没有额外求解最优传输配对。
生成时,我们仍然不知道终点图片,只拿到一份新的噪声。每一步问网络当前速度,再往前走:
这叫前向欧拉法。若分成 32 步,,每走一步便重新估计速度。
这里有一个很容易误会的地方:训练用直线连接端点,不代表生成时沿着某条已知直线前进。 许多随机配对会经过附近位置,网络只能根据当前状态、时间和条件给出估计。它学到的整体速度场,可能使生成轨迹弯曲;具体误差还与模型、训练和数值步长有关。
图 2 的第三行展示了真实轨迹。流匹配每步没有额外抽噪声,但起点是随机的,因此仍能产生不同样本。扩散与流匹配也不是两个毫无关系的世界:它们都涉及如何连接噪声分布与数据分布,只是这里选择了不同路径、训练目标和采样算法。更完整的视角可读 Flow Matching for Generative Modeling。
6. 把三个小实验跑起来
数据继续使用第十五章的手写数字:训练 1077 张、验证 360 张、测试 360 张,划分完全相同。来源为 Alpaydin 与 Kaynak 的 UCI Optical Recognition of Handwritten Digits,由 scikit-learn 提供 8×8 图像,数据页标示 CC BY 4.0。这个划分已在前面多次使用,是公开的教学与回归数据,不是尚未见过的独立研究基准。
配置在运行前固定如下:
| 项目 | 自编码器 | DDPM / 流匹配 |
|---|---|---|
| 输入 | 的 64 个像素 | 的 64 个像素、时间、类别 |
| 网络 | 两层宽度 128 的隐藏层 | |
| 参数量 | 4744 | 各 36448 |
| 训练轮数上限 | 80 | 各 120 |
| 优化器 | Adam,学习率 0.002 | 相同 |
| 批量大小 | 128 | 相同 |
| 选择依据 | 验证重建 MSE | 各自的验证目标 MSE |
三个模型独立训练。这里的 DDPM 和流匹配直接生成 64 个像素,没有使用前面自编码器的 8 维潜变量;后面的预训练模型才展示潜空间生成。
网络使用 SiLU 激活;自编码器的最后一层使用 Sigmoid。时间先转成原始时间及四组正弦、余弦特征,与类别嵌入一起输入网络。两种生成网络的验证图片、噪声和时间在训练前固定,避免每轮换题造成选择指标的额外波动;训练批次则持续抽取新噪声。
在仓库根目录运行:
uv run --python 3.12 --with-requirements requirements.txt \
  python src/examples/image_generation_basics.py
这条命令会实际从零训练三个模型,再生成和评价图片。CPU 即可运行。本次在 macOS arm64、Python 3.12.12、PyTorch 2.14.1、NumPy 2.5.4 的单线程环境中,脚本内部计时约 2 秒,不含启动和导入依赖;其他设备耗时会不同。
需要保存本次全部结果时,加上:
uv run --python 3.12 --with-requirements requirements.txt \
  python src/examples/image_generation_basics.py \
  --out runs/image-generation-basics.json
脚本复用 digits_project.py 的数据划分,完整实现也可以下载查看。
展开完整的小模型实验代码
"""第 42 章:8×8 数字上的自编码、条件 DDPM 与条件流匹配;CPU 从零训练。"""

from argparse import ArgumentParser
from copy import deepcopy
from hashlib import sha256
import json
from math import pi
from pathlib import Path
import platform
from time import perf_counter

import numpy as np
from sklearn.linear_model import LogisticRegression
import torch
from torch import nn

from digits_project import make_data


STEPS = 64
EPOCHS = {"autoencoder": 80, "ddpm": 120, "flow": 120}


def tensor_hash(tensor):
    return sha256(tensor.detach().cpu().contiguous().numpy().tobytes()).hexdigest()


def schedule(steps=STEPS):
    # 余弦 alpha_bar 曲线;限制最后一步 beta,避免除以零。
    grid = torch.arange(steps + 1, dtype=torch.float64) / steps
    curve = torch.cos((grid + 0.008) / 1.008 * pi / 2).square()
    curve = curve / curve[0]
    beta = (1 - curve[1:] / curve[:-1]).clamp(max=0.999).float()
    alpha_bar = torch.cat([torch.ones(1), (1 - beta).cumprod(0)])
    return beta, alpha_bar


def add_noise(clean, noise, level, alpha_bar):
    a = alpha_bar[level, None]
    return a.sqrt() * clean + (1 - a).sqrt() * noise


def flow_pair(clean, noise, time):
    return (1 - time[:, None]) * noise + time[:, None] * clean, clean - noise


class Autoencoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(nn.Linear(64, 32), nn.SiLU(), nn.Linear(32, 8))
        self.decoder = nn.Sequential(nn.Linear(8, 32), nn.SiLU(),
                                     nn.Linear(32, 64), nn.Sigmoid())

    def forward(self, images):
        return self.decoder(self.encoder(images))


class Field(nn.Module):
    def __init__(self):
        super().__init__()
        self.labels = nn.Embedding(10, 16)
        self.network = nn.Sequential(nn.Linear(64 + 9 + 16, 128), nn.SiLU(),
                                     nn.Linear(128, 128), nn.SiLU(),
                                     nn.Linear(128, 64))

    def forward(self, images, time, labels):
        angles = time[:, None] * (2 * pi * 2 ** torch.arange(4))
        clock = torch.cat([time[:, None], angles.sin(), angles.cos()], dim=1)
        return self.network(torch.cat([images, clock, self.labels(labels)], dim=1))


def training_pair(kind, clean, generator, alpha_bar):
    noise = torch.randn(clean.shape, generator=generator)
    if kind == "ddpm":
        level = torch.randint(1, STEPS + 1, (len(clean),), generator=generator)
        return add_noise(clean, noise, level, alpha_bar), level / STEPS, noise
    time = torch.rand(len(clean), generator=generator)
    mixed, velocity = flow_pair(clean, noise, time)
    return mixed, time, velocity


def train(kind, training, validation):
    torch.manual_seed(2026 if kind == "autoencoder" else 2030)
    model = Autoencoder() if kind == "autoencoder" else Field()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.002)
    generator = torch.Generator().manual_seed(3031)
    _, alpha_bar = schedule()
    x, y = training
    vx, vy = validation
    if kind != "autoencoder":
        x, vx = 2 * x - 1, 2 * vx - 1
        validation_pair = training_pair(
            kind, vx, torch.Generator().manual_seed(3030), alpha_bar)
    best, history = float("inf"), []
    for epoch in range(1, EPOCHS[kind] + 1):
        model.train()
        total = 0.0
        for ids in torch.randperm(len(x), generator=generator).split(128):
            optimizer.zero_grad(set_to_none=True)
            if kind == "autoencoder":
                output, target = model(x[ids]), x[ids]
            else:
                mixed, time, target = training_pair(kind, x[ids], generator, alpha_bar)
                output = model(mixed, time, y[ids])
            loss = (output - target).square().mean()
            if not torch.isfinite(loss):
                raise RuntimeError("训练出现非有限损失")
            loss.backward()
            optimizer.step()
            total += loss.item() * len(ids)
        model.eval()
        with torch.no_grad():
            if kind == "autoencoder":
                loss = (model(vx) - vx).square().mean().item()
            else:
                mixed, time, target = validation_pair
                loss = (model(mixed, time, vy) - target).square().mean().item()
        history.append([total / len(x), loss])
        if loss < best:
            best, best_epoch, state = loss, epoch, deepcopy(model.state_dict())
    model.load_state_dict(state)
    model.eval()
    fingerprint = sha256(b"".join(
        value.numpy().tobytes() for value in state.values())).hexdigest()
    return model, {"epoch": best_epoch, "validation_mse": best,
                   "history": history, "parameters": sum(p.numel() for p in model.parameters()),
                   "weights_sha256": fingerprint}


def reverse_step(noisy, epsilon, step, beta, alpha_bar, noise):
    b, current, previous = beta[step - 1], alpha_bar[step], alpha_bar[step - 1]
    clean = ((noisy - (1 - current).sqrt() * epsilon) / current.sqrt()).clamp(-1, 1)
    mean = (previous.sqrt() * b * clean
            + (1 - b).sqrt() * (1 - previous) * noisy) / (1 - current)
    variance = b * (1 - previous) / (1 - current)
    return mean + variance.sqrt() * noise


@torch.no_grad()
def sample(kind, model, labels, steps=32, seed=4040):
    generator = torch.Generator().manual_seed(seed)
    x = torch.randn((len(labels), 64), generator=generator)
    initial_hash = tensor_hash(x)
    snapshots = [x[0].tolist()]
    positions = [0]
    if kind == "ddpm":
        beta, alpha_bar = schedule()
        for step in range(STEPS, 0, -1):
            time = torch.full((len(x),), step / STEPS)
            epsilon = model(x, time, labels)
            noise = torch.randn(x.shape, generator=generator) if step > 1 else torch.zeros_like(x)
            x = reverse_step(x, epsilon, step, beta, alpha_bar, noise)
            if step in [49, 33, 17, 1]:
                snapshots.append(x[0].tolist())
                positions.append(STEPS - step + 1)
    else:
        for step in range(steps):
            time = torch.full((len(x),), step / steps)
            x = x + model(x, time, labels) / steps
            if (step + 1) % (steps // 4) == 0:
                snapshots.append(x[0].tolist())
                positions.append(step + 1)
    return ((x + 1) / 2).clamp(0, 1), {
        "initial_noise_sha256": initial_hash, "snapshots": snapshots,
        "snapshot_steps": positions, "evaluations": STEPS if kind == "ddpm" else steps,
        "raw_outside_fraction": ((x < -1) | (x > 1)).float().mean().item()}


def run():
    started = perf_counter()
    torch.set_num_threads(1)
    torch.use_deterministic_algorithms(True)
    raw, ids = make_data()
    data = [(x.flatten(1).float() / 16, y) for x, y in raw]
    training, validation, test = data
    report = {"split_ids": [index.tolist() for index in ids],
              "environment": {"python": platform.python_version(),
                              "torch": torch.__version__, "numpy": np.__version__,
                              "platform": platform.platform(), "threads": 1},
              "config": {"epochs": EPOCHS, "batch_size": 128, "lr": 0.002,
                         "ddpm_steps": STEPS, "flow_steps": 32,
                         "sample_seed": 4040, "train_seed": 3031,
                         "validation_seed": 3030},
              "source_sha256": sha256(Path(__file__).read_bytes()).hexdigest(),
              "data_sha256": [tensor_hash(x) for x, _ in data]}
    ae, record = train("autoencoder", training, validation)
    with torch.no_grad():
        reconstruction = ae(test[0])
        record["test_mse"] = (reconstruction - test[0]).square().mean().item()
        record["mean_baseline_mse"] = (
            training[0].mean(0) - test[0]).square().mean().item()
        chosen = [int(torch.where(test[1] == label)[0][0]) for label in range(10)]
        record["image_ids"] = ids[2][chosen].tolist()
        record["originals"] = test[0][chosen].tolist()
        record["reconstructions"] = reconstruction[chosen].tolist()
        random_latent = torch.randn((10, 8), generator=torch.Generator().manual_seed(4041))
        record["random_latent_decodes"] = ae.decoder(random_latent).tolist()
    report["autoencoder"] = record
    classifier = LogisticRegression(C=1, max_iter=1000).fit(*[v.numpy() for v in training])
    report["classifier_real_accuracy"] = float(classifier.score(
        test[0].numpy(), test[1].numpy()))
    labels = torch.arange(10).repeat_interleave(10)
    report["sample_labels"] = labels.tolist()
    for kind in ["ddpm", "flow"]:
        model, record = train(kind, training, validation)
        samples, trajectory = sample(kind, model, labels)
        predicted = classifier.predict(samples.numpy())
        record.update(trajectory)
        record.update({"samples": samples.tolist(), "predicted": predicted.tolist(),
                       "condition_correct": int((predicted == labels.numpy()).sum())})
        report[kind] = record
    _, alpha_bar = schedule()
    clean = 2 * test[0][chosen[3]:chosen[3] + 1] - 1
    noise = torch.randn(clean.shape, generator=torch.Generator().manual_seed(4042))
    report["forward"] = {"image_id": int(ids[2][chosen[3]]), "levels": [0, 16, 32, 48, 64],
                         "images": [add_noise(clean, noise, torch.tensor([i]), alpha_bar)[0].tolist()
                                    for i in [0, 16, 32, 48, 64]],
                         "alpha_bar": alpha_bar.tolist()}
    report["elapsed_seconds"] = perf_counter() - started
    return report


def show(report):
    ae = report["autoencoder"]
    print("训练/验证/测试:1077 / 360 / 360;图像:8×8")
    print(f"自编码器:最佳轮次={ae['epoch']},测试 MSE={ae['test_mse']:.4f}")
    print(f"训练均值图基线 MSE={ae['mean_baseline_mse']:.4f}")
    print(f"代理分类器真实测试准确率={report['classifier_real_accuracy']:.3f}")
    for kind in ["ddpm", "flow"]:
        row = report[kind]
        print(f"{kind}:最佳轮次={row['epoch']},验证目标 MSE={row['validation_mse']:.4f},"
              f"条件识别={row['condition_correct']}/100,采样调用={row['evaluations']}")
    print("条件识别只检查生成数字是否被分类器认作指定类别,不代表整体生成质量。")


if __name__ == "__main__":
    parser = ArgumentParser(description=__doc__)
    parser.add_argument("--out", type=Path, help="保存本次完整训练、像素和评价记录")
    args = parser.parse_args()
    result = run()
    if args.out:
        args.out.parent.mkdir(parents=True, exist_ok=True)
        args.out.write_text(json.dumps(result, ensure_ascii=False, indent=2) + "\n")
    show(result)
本次运行输出为:
训练/验证/测试:1077 / 360 / 360;图像:8×8
自编码器:最佳轮次=80,测试 MSE=0.0196
训练均值图基线 MSE=0.0733
代理分类器真实测试准确率=0.975
ddpm:最佳轮次=116,验证目标 MSE=0.2826,条件识别=98/100,采样调用=64
flow:最佳轮次=120,验证目标 MSE=0.5916,条件识别=95/100,采样调用=32
条件识别只检查生成数字是否被分类器认作指定类别,不代表整体生成质量。
自编码器比“对每张输入都输出训练集平均图”的基线误差更小,说明它保留了输入相关的信息。但图 1 也提醒我们,较低的重建误差并不自动保证随机潜变量能生成清楚的数字。
两种生成方法各画 100 张,0~9 每类十张。起始噪声使用相同种子 4040;DDPM 的反向过程还会额外抽噪声,流匹配则使用 32 次欧拉更新。下图取每类生成顺序中的第一张:
图 3:标题中的箭头表示“指定类别 → 分类器识别”。按类别和生成顺序直接选取,未筛选最好看的样本。展示与评分前,最终像素统一映射并截到 。
“条件识别”由一个只在真实训练集上拟合的逻辑回归分类器给出。它在真实测试图上的准确率为 0.975,但生成图可能偏离真实数据分布,所以它也会误判。下图保留了本次全部七个条件识别未通过的样本:
图 4:编号从 0 开始,对应各模型保存的 100 张生成图。这里的“失败”专指分类器未认作指定数字;请同时观察图像,不要把分类器判断当成人类一致结论。
例如 DDPM 的第 36 张本想画 3,却被认作 9;流匹配的第 30 张也想画 3,却被认作 2。笔画连接、开口与灰度变化都可能影响识别。
我们能据此宣布 DDPM 更好吗?还不能。它用了 64 次网络调用,流匹配用了 32 次;这是两份教学配置,只有一个训练种子,目标的数值尺度也不同。0.2826 的噪声 MSE 和 0.5916 的速度 MSE,不能直接当成同一种考试分数比较。
完整记录保存了划分 ID、参数量、每轮损失、选中轮次、种子、权重与源码指纹、全部 200 张生成图的像素和预测结果。你可以据此重新作图,也可以另存一次新运行,观察复现差异。
7. 从小数字走到文字生成图片
如果把 512×512 的彩色图片直接展开,网络要处理 个数。实际模型会用卷积、注意力等结构组织计算,还经常借助第一节的思路:先在一个较小的潜空间里生成,最后再解码成像素。
这就是潜空间扩散的一种基本流程:
图片编码器把训练图变成潜表示 → 在潜表示上学习去噪 → 生成时从潜噪声出发 → 图片解码器把结果还原为像素。
文本编码器提供条件,图像生成网络读取这些条件。这里的潜表示通常仍保留空间布局,不是一个孤零零的类别向量。例如本节模型的初始潜噪声形状为 ,分别对应批次、通道、高度、宽度;最终解码得到 512×512 的图片。每个潜通道也不是直接对应红、绿、蓝。
Latent Diffusion Models把压缩表示与条件生成结合起来。压缩会丢失信息,解码器的能力也限制最终图像;把生成搬到潜空间,并不意味着所有细节都能完整保存。
一步生成,靠的不只是少写几个循环
这里选择真实预训练模型 SD-Turbo。它由 Stable Diffusion 2.1 蒸馏而来,采用 Adversarial Diffusion Distillation,针对很少的采样步骤训练。它的一步结果不能用来说明“普通 DDPM 随便删到一步也一样好”。
我们依照该模型的使用说明,使用 512×512、guidance_scale=0.0,不传负面提示。这个配置仍然使用文字条件;0 表示关闭此管线的常规 CFG 放大,不能套用前面通用 CFG 公式来断言它变成了无条件生成。
模型修订固定为 b261bac6fd2cf515557d5d0707481eafa0485ec2。下载三个 FP16 权重文件共 2,580,060,470 字节,加载后在 CPU 上使用 FP32 运算;文本编码器、U-Net、VAE 合计约 12.90 亿参数。仅 FP32 参数约需 5.16 GB,运行时还要留出激活和临时张量空间。本次在 18 GiB 内存机器上完成。
这部分实验使用 SD-Turbo,Powered by Stability AI。权重不随书分发,使用条件见该修订的 Stability AI Community License;不要把它与本书的小型自训练网络混为一谈。
六次对照,一次写好再运行
先固定两条仅颜色不同的提示:
A studio photograph of one red ceramic mug on a plain white table, soft natural light.
A studio photograph of one blue ceramic mug on a plain white table, soft natural light.
用种子 2026 和 2027 各生成一次,均为一步。接着对“红杯、2026”增加一个四步版本。最后增加一条有明确数量和文字要求的提示:
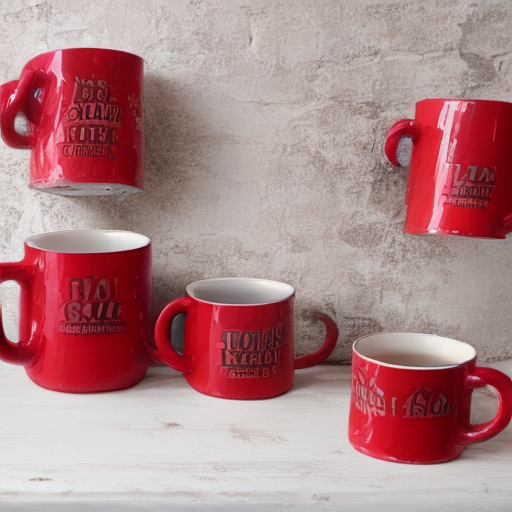
A studio photograph of exactly three red ceramic mugs on a white table, each labeled TEA in clear black letters.
最后这条使用种子 2026、一步生成。六种配置在运行前固定,没有看到图片后改提示、换种子或挑选成功图片。
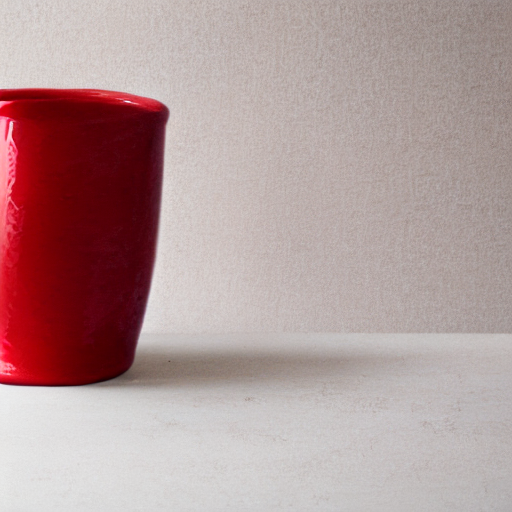
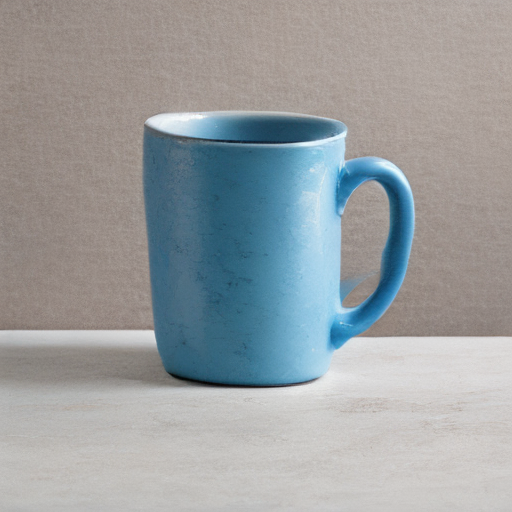
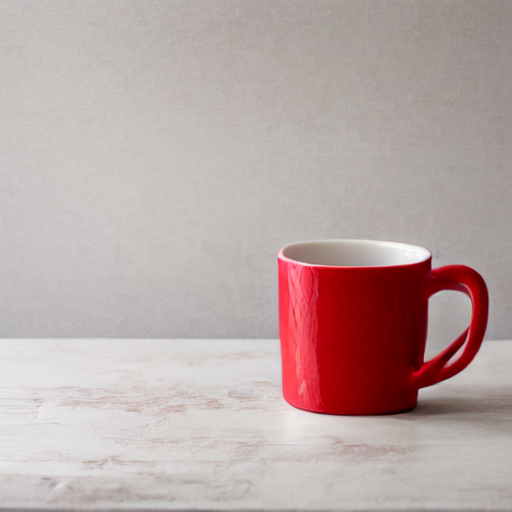
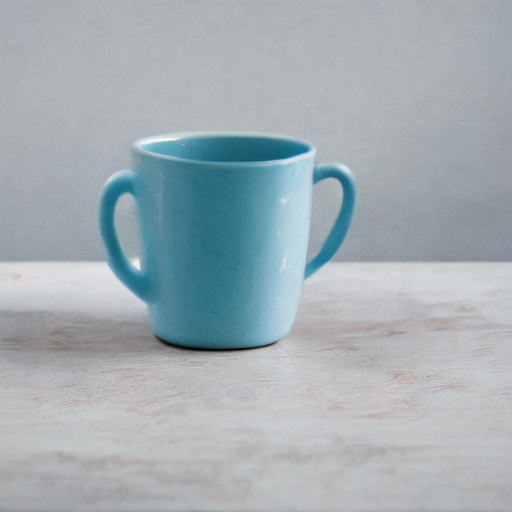
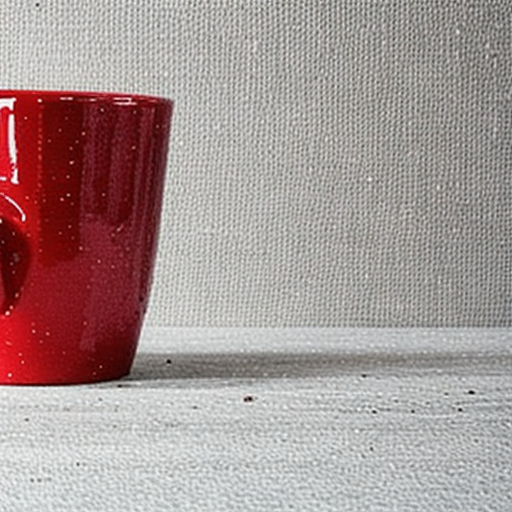
图 5:全部六次输出。每一行从左到右阅读;同一种子的标准正态潜噪声及缩放后的起始潜变量指纹一致。展示的是模型生成图片,不是实物照片。
看图时,先把“符合要求”和“我觉得漂亮”分开:
- 颜色:前四张都出现了与提示大致对应的红色或蓝色杯体。
- 构图与结构:种子 2026 的红杯被左侧边界截断,蓝杯却较完整。种子 2027 的蓝杯出现左右两个把手。改一个颜色词,其他结构也可能变化。
- 步数:同为红杯、种子 2026,四步版本仍被截断,背景纹理更粗糙。仅这一对图片不能推出“步数越多越差”或“越多越好”。
- 数量和文字:最后一张可以数到五只杯子,其中两只位于上方;它没有满足“三只”的条件,也没有清楚、统一地写出 TEA。
这就是固定种子的实际意义:它控制了一部分随机性,方便比较配置,不会把模型变成只修改某个指定属性的图片编辑器。
运行与保留证据
先只核对本书保存的六次结果,不需要加载模型:
python3 src/examples/pretrained_image_generation.py
输出为:
模型:stabilityai/sd-turbo;revision=b261bac6fd2cf515557d5d0707481eafa0485ec2
已保存 6 次真实生成:512×512,CPU float32,guidance_scale=0
red-2026-1:1 步,seed=2026,图像指纹通过
blue-2026-1:1 步,seed=2026,图像指纹通过
red-2027-1:1 步,seed=2027,图像指纹通过
blue-2027-1:1 步,seed=2027,图像指纹通过
red-2026-4:4 步,seed=2026,图像指纹通过
three-tea-2026-1:1 步,seed=2026,图像指纹通过
同一种子各组的起始噪声一致;默认模式只核对记录,不重新生成。
要实际重新生成,使用一个新的输出目录:
uv run --python 3.12 \
  --with-requirements src/examples/requirements-generation.txt \
  python src/examples/pretrained_image_generation.py \
  --run --out runs/sd-turbo-new
首次运行会下载模型;后续使用本地缓存。可选环境固定 Diffusers 0.35.2、Transformers 4.57.3、Accelerate 1.11.0 与 PyTorch 2.14.1。脚本使用 CPU、FP32、4 线程和默认 EulerDiscreteScheduler,一步的时间点为 999,四步为 999、749、499、249。
本次五个一步调用耗时约 9.95~15.63 秒,四步调用约 17.72 秒。计时包括文本编码、生成与图像解码,不含下载、模型加载和写 PNG;没有专门做重复预热计时,因此这些数用于估计本次实验成本,不能当作稳定的速度基准。
完整的原始记录包含提示、种子、软件版本、调度器配置、模型文件指纹、起始潜变量指纹、实际耗时和输出文件指纹。六张原图也可分别打开:红杯 2026、蓝杯 2026、红杯 2027、蓝杯 2027、四步红杯、数量与文字。跨设备或软件版本运行时,即使种子相同,也不应承诺逐像素一致。
展开预训练模型实验代码
"""第 42 章:真实 SD-Turbo 条件生成。默认核对已保存记录;--run 才加载模型。"""

from argparse import ArgumentParser
from hashlib import sha256
import json
from pathlib import Path
import platform
import struct
from time import perf_counter


MODEL = "stabilityai/sd-turbo"
REVISION = "b261bac6fd2cf515557d5d0707481eafa0485ec2"
DEFAULT = Path(__file__).parent / "data" / "sd-turbo" / "report.json"
PROMPT = "A studio photograph of one {} ceramic mug on a plain white table, soft natural light."
CASES = [
    {"id": f"{color}-{seed}-1", "prompt": PROMPT.format(color),
     "seed": seed, "steps": 1}
    for seed in [2026, 2027] for color in ["red", "blue"]
] + [
    {"id": "red-2026-4", "prompt": PROMPT.format("red"), "seed": 2026, "steps": 4},
    {"id": "three-tea-2026-1", "prompt": (
        "A studio photograph of exactly three red ceramic mugs on a white table, "
        "each labeled TEA in clear black letters."), "seed": 2026, "steps": 1},
]


def file_hash(path):
    digest = sha256()
    with Path(path).open("rb") as source:
        for chunk in iter(lambda: source.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()


def validate(path=DEFAULT):
    report = json.loads(path.read_text())
    assert report["model"] == MODEL and report["revision"] == REVISION
    assert report["source_sha256"] == file_hash(__file__), "记录对应的脚本版本已改变"
    assert report["cases"] == CASES and len(report["outputs"]) == len(CASES)
    for case, row in zip(CASES, report["outputs"]):
        assert all(row[k] == v for k, v in case.items())
        filename = path.parent / row["image"]
        assert filename.name == case["id"] + ".png"
        assert file_hash(filename) == row["image_sha256"]
        header = filename.read_bytes()[:24]
        assert header[:8] == b"\x89PNG\r\n\x1a\n"
        assert struct.unpack(">II", header[16:24]) == (512, 512)
        assert len(row["timesteps"]) == case["steps"] and row["seconds"] > 0
    for seed in [2026, 2027]:
        group = [r for r in report["outputs"] if r["seed"] == seed]
        assert len({r["noise_sha256"] for r in group}) == 1
        assert len({r["initial_latent_sha256"] for r in group}) == 1
    return report


def run(folder):
    # 所有模型推理依赖放在显式运行分支,默认检查只需标准库。
    import accelerate
    import diffusers
    import numpy as np
    import torch
    import transformers
    from diffusers import StableDiffusionPipeline
    from huggingface_hub import snapshot_download

    report_path = folder / "report.json"
    if report_path.exists() or any(folder.glob("*.png")):
        raise ValueError("输出目录已有实验结果,请换一个空目录以保留原始记录")
    folder.mkdir(parents=True, exist_ok=True)
    torch.set_num_threads(4)
    torch.use_deterministic_algorithms(True)
    snapshot = Path(snapshot_download(
        MODEL, revision=REVISION, allow_patterns=[
            "model_index.json", "scheduler/*.json", "text_encoder/config.json",
            "text_encoder/model.fp16.safetensors", "tokenizer/*", "unet/config.json",
            "unet/diffusion_pytorch_model.fp16.safetensors", "vae/config.json",
            "vae/diffusion_pytorch_model.fp16.safetensors", "README.md", "LICENSE.md"]))
    pipeline = StableDiffusionPipeline.from_pretrained(
        snapshot, variant="fp16", torch_dtype=torch.float32,
        local_files_only=True, use_safetensors=True).to("cpu")
    pipeline.set_progress_bar_config(disable=True)
    report = {
        "model": MODEL, "revision": REVISION, "cases": CASES, "outputs": [],
        "source_sha256": file_hash(__file__),
        "environment": {"python": platform.python_version(), "platform": platform.platform(),
                        "torch": torch.__version__, "numpy": np.__version__,
                        "diffusers": diffusers.__version__, "transformers": transformers.__version__,
                        "accelerate": accelerate.__version__, "device": "cpu",
                        "dtype": "float32", "threads": 4},
        "settings": {"height": 512, "width": 512, "guidance_scale": 0.0,
                     "variant": "fp16", "negative_prompt": None},
        "scheduler": type(pipeline.scheduler).__name__,
        "scheduler_config": dict(pipeline.scheduler.config),
        "weights": [{"file": str(p.relative_to(snapshot)), "bytes": p.stat().st_size,
                     "sha256": file_hash(p)} for p in sorted(snapshot.rglob("*.safetensors"))],
        "license_sha256": file_hash(snapshot / "LICENSE.md"),
        "parameters": {name: sum(p.numel() for p in getattr(pipeline, name).parameters())
                       for name in ["text_encoder", "unet", "vae"]},
    }

    def tensor_hash(tensor):
        return sha256(tensor.contiguous().numpy().tobytes()).hexdigest()

    for case in CASES:
        generator = torch.Generator(device="cpu").manual_seed(case["seed"])
        noise = torch.randn((1, 4, 64, 64), generator=generator, dtype=torch.float32)
        pipeline.scheduler.set_timesteps(case["steps"])
        initial = noise * pipeline.scheduler.init_noise_sigma
        started = perf_counter()
        with torch.inference_mode():
            result = pipeline(prompt=case["prompt"], height=512, width=512,
                              num_inference_steps=case["steps"], guidance_scale=0.0,
                              latents=noise.clone(), generator=generator)
        elapsed = perf_counter() - started
        filename = folder / (case["id"] + ".png")
        result.images[0].save(filename)
        row = {**case, "image": filename.name, "image_sha256": file_hash(filename),
               "noise_sha256": tensor_hash(noise),
               "initial_latent_sha256": tensor_hash(initial),
               "init_noise_sigma": float(pipeline.scheduler.init_noise_sigma),
               "timesteps": pipeline.scheduler.timesteps.tolist(), "seconds": elapsed,
               "prompt_tokens": pipeline.tokenizer(case["prompt"]).input_ids,
               "nsfw_content_detected": result.nsfw_content_detected}
        report["outputs"].append(row)
        report_path.write_text(json.dumps(report, ensure_ascii=False, indent=2) + "\n")
        print(f"{case['id']}:完成,{elapsed:.2f} 秒", flush=True)
    validate(report_path)
    return report


def show(report):
    print(f"模型:{report['model']};revision={report['revision']}")
    print("已保存 6 次真实生成:512×512,CPU float32,guidance_scale=0")
    for row in report["outputs"]:
        print(f"{row['id']}:{row['steps']} 步,seed={row['seed']},图像指纹通过")
    print("同一种子各组的起始噪声一致;默认模式只核对记录,不重新生成。")


if __name__ == "__main__":
    parser = ArgumentParser(description=__doc__)
    parser.add_argument("--run", action="store_true", help="下载/加载固定模型并实际生成")
    parser.add_argument("--out", type=Path, help="真实生成使用的空输出目录")
    parser.add_argument("--record", type=Path, default=DEFAULT, help="默认核对的 JSON 路径")
    args = parser.parse_args()
    if args.run and args.out is None:
        parser.error("--run 需要 --out 指定一个空目录")
    show(run(args.out) if args.run else validate(args.record))
也可以下载脚本检查输入如何固定、输出如何保存。它不会把生成错误的图片删掉,也不会用自动评分改写图片内容。
8. 生成得好不好,该看什么
重建任务有明确的原图,可以逐像素比较。开放式生成则不同:同一句“红色杯子”,合理的杯子形状、角度、光照本来就有很多种。拿某一张参考照片逐像素算 MSE,可能惩罚一个完全合理的新构图。
可以把问题分成几条:
| 关心什么 | 可以怎样检查 | 单独使用时会漏掉什么 |
|---|---|---|
| 视觉质量 | 观察边缘、结构、纹理、遮挡 | 漂亮图片也可能不符合提示 |
| 条件符合程度 | 检查颜色、数量、位置、文字等具体要求 | 满足条件也可能模糊或重复 |
| 多样性 | 同一提示用多个种子生成,观察构图与细节分布 | 变化很大也可能只是错误很多 |
| 与真实分布的接近程度 | 在统一协议下比较一批生成与真实图片的特征分布 | 不一定检查每条提示的要求 |
| 记忆与近似复制 | 与训练数据或可用参考库做近邻检索并人工核对 | 找不到近邻不代表已经排除记忆 |
论文中常见 FID,由 Heusel 等人在这篇论文中提出。它在 Inception 特征空间里,用均值和协方差概括真实图片与生成图片,再比较两者。它评价的是一批样本的分布差异,不是单张图的“艺术分”,也不直接检查杯子是否恰好有三只。
比较 FID 时,要同时报告参考数据、生成样本数、特征提取与预处理协议。样本少、数据域不合适或预处理不同,分数就很难直接比较。本章没有给 8×8 数字或六张杯子计算一个貌似正式的 FID。
图文相似度模型可以帮助检查大体语义,但“都是杯子”和“恰好三只杯子,每只都有 TEA”相差很远。模型评分也可能对某些构图或风格有偏好。实际项目里,可以事先拆出条件清单,盲评多个种子,记录分歧,再把自动指标与人工观察一起报告。
本章的 98/100、95/100 只回答了一个有限问题:指定数字有没有被这个分类器认出来。六张 SD-Turbo 图片则只是受控示例,不是模型能力排行榜。想研究某种方法是否更好,还需要更多提示、种子、相同预算和独立评估。
9. 亲手改变一次实验
- 自编码器把 64 个像素变成 8 个潜变量,是否可以直接宣称存储空间缩小八倍?为什么?
- 如果普通自编码器重建误差很小,为什么随机标准正态潜变量仍可能生成奇怪的图?
- 当 时,直接加噪公式中原图和噪声的系数各是多少?若某个像素 、噪声为 ,结果是多少?
- DDPM 训练时为什么既要输入带噪图片,也要输入时间?知道加进去的噪声,是否意味着推理时也知道真实噪声?
- 在本章通用 CFG 写法中,取 、、,得到多少?为什么这不是两个结果之间的普通加权平均?
- 流匹配中取 、。求 的位置与目标速度,再用步长 0.25 走到终点。
- 为什么不能比较 0.2826 与 0.5916,就判断两个生成模型中谁更好?
- 想公平比较 32 步与 64 步流匹配,训练好的网络是否需要改变?应固定哪些条件,记录哪些结果?
- 如果把前四张杯子中的两张漂亮图片留下,其余不展示,会怎样影响别人对结果的判断?设计一个更可靠的颜色与数量评价方案。
- 在自己的新输出目录中增加一个种子。保持提示、模型和采样步骤不变,保存完整图片与参数;描述变化,也说明这次观察不能证明什么。
展开参考答案与实验提示
- 不能。这只说明表示维度减少;原图与潜变量的数值精度、存储格式、压缩编码和模型大小都影响实际空间。
- 训练只约束经过编码器得到的潜变量。随机先验未必与这些表示的分布一致,解码器可能收到不熟悉的位置。
- 两个系数是 与 ;结果为 。
- 时间说明信号与噪声的比例。训练时噪声由我们抽取,可作监督目标;生成时只有当前状态,网络预测的是噪声估计,不会拿到目标原图对应的“正确答案”。
- 。当 时发生外推,结果可以超出两种估计之间的区间。
- 位置为 ,速度为 4。每步前进 1,依次到 0、1、2、3。这是已知端点的恒定速度例子;实际生成中的速度由网络重新估计。
- 两种损失预测的量不同,不能直接比较数值;采样调用次数也不同。还要区分条件符合、质量、多样性和计算成本,并使用多个种子。
- 可以先固定同一个训练好且已按验证规则选中的网络,再改变欧拉步数。固定标签、初始噪声和显示处理,记录全部样本、条件检查、时间和网络调用次数。步数更多只减少某些离散误差,不保证弥补模型学错的速度场。
- 筛选会隐藏失败率。可以预先固定提示集合、种子与数量要求,把全部输出编号,按颜色、杯子数量、把手结构等项目逐项盲评,保存分歧和原图,避免把一张漂亮样例当作总体表现。
- 至少保存模型修订、提示、种子、调度器、时间点、精度、环境和原图。单个新种子只能补充一个案例,不能据此判断通用成功率或跨设备复现保证。
下一章音频、视频与统一多模态系统,把静态图片换成随时间变化的声音和视频。我们会继续追问同一个问题:输入里有哪些信息,模型保留了什么,又会在哪里把看似合理的内容生成错?